Transparantieverklaring: ownvia is een product van SATRI Consulting. Dit artikel dient ter vakinhoudelijke informatie en vormt geen juridisch advies.
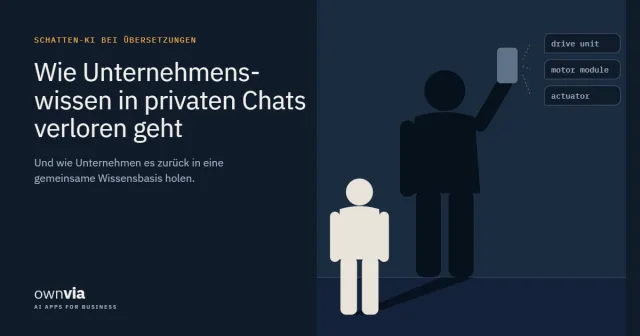
Generatieve AI geeft de zin een nieuwe betekenis. Medewerkers vertalen dagelijks offertes, handleidingen en e-mails met ChatGPT en andere AI-tools. Daarbij leren ze de AI hoe hun bedrijf communiceert: welke vaktermen gelden, welke toon bij de klant past en hoe een product heet. Deze kennis blijft echter meestal in de persoonlijke chatgeschiedenis en wordt geen onderdeel van een gemeenschappelijke kennisbasis.
Kort antwoord: Schaduw-AI bij vertalingen is niet alleen een privacyrisico, maar vooral een kennisprobleem. Bedrijfskennis vloeit naar privé-AI-chats, maar komt niet terug. Elke correctie, elke vakterm en elke geslaagde formulering blijft bij de individuele medewerker. Verboden bieden zelden een oplossing. Effectiever is een gemeenschappelijke omgeving waarin terminologie, goedgekeurde vertalingen en richtlijnen centraal worden beheerd en iedereen ervan profiteert.
Hoe wijdverbreid is schaduw-AI in bedrijven?
Schaduw-AI verwijst naar het gebruik van AI-tools buiten de toepassingen die een bedrijf beschikbaar stelt of heeft goedgekeurd. Twee recente onderzoeken laten zien dat dit in Duitse bedrijven dagelijkse praktijk is.
Onderzoek | Resultaat |
|---|---|
Bedrijfsenquête van Bitkom, gepubliceerd in oktober 2025, 604 bedrijven met 20 of meer werknemers | In 8% van de bedrijven wordt het gebruik van privé-AI-tools op grote schaal toegepast; in nog eens 17% zijn er afzonderlijke gevallen en 17% vermoedt dit, zonder het zeker te weten. |
Werknemersonderzoek van het Institut der deutschen Wirtschaft, maart/april 2026, bijna 5.000 werknemers | 29,1% van de werknemers die AI beroepsmatig gebruiken, maakt ook gebruik van tools die niet door hun werkgever beschikbaar zijn gesteld. |
Gezamenlijk rapporteert of vermoedt dus 42% van de door Bitkom ondervraagde bedrijven het gebruik van schaduw-AI. ‘Niet beschikbaar gesteld’ betekent daarbij niet automatisch ‘verboden’. Het laat wel zien dat het daadwerkelijke AI-gebruik en de officiële processen uiteenlopen.
Een bevinding van het IW is verrassend: schaduw-AI komt het vaakst voor waar werkgevers de ontwikkeling van AI-vaardigheden stimuleren – 44,5% van de werknemers met sterke ondersteuning gebruikt niet-beschikbaar gestelde tools, tegenover 21,3% zonder ervaren ondersteuning. Het IW spreekt van een beschikbaarheidskloof: de bereidheid van werknemers groeit sneller dan het officiële aanbod. Volgens Bitkom stelt slechts 26% van de bedrijven generatieve AI beschikbaar aan hun medewerkers. Schaduw-AI is daarmee minder een teken van regelovertreding dan een teken van een onvervulde behoefte.
Bij vertalingen weegt dit extra zwaar. Anders dan bij een korte zoekopdracht wordt hier meestal het volledige document aan de AI toevertrouwd – inclusief vakkennis, klantgegevens en productdetails.
Wat werknemers de AI dagelijks aanleren
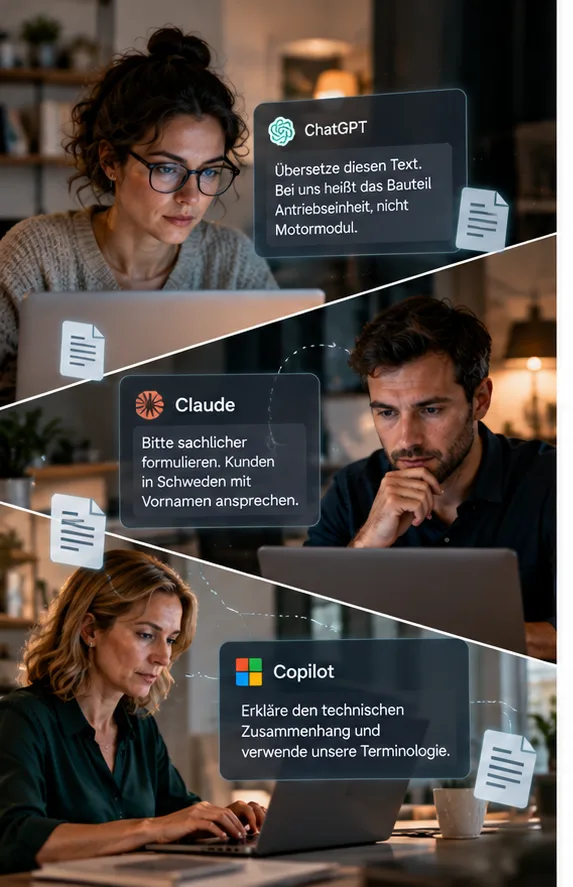
Wie met AI vertaalt, voert niet alleen tekst in. Goede resultaten ontstaan pas wanneer werknemers aan de AI uitleggen hoe hun bedrijf communiceert. ‘Aanleren’ verwijst hierbij naar instructies en context in de betreffende chat, niet naar het trainen van het AI-model. Typische instructies uit de dagelijkse praktijk:
- Terminologie: „Bij ons heet dit onderdeel aandrijfeenheid, niet motormodule.“
- Tonaliteit: „We spreken klanten in Zweden aan met hun voornaam.“
- Productkennis: Uitleg over technische verbanden, zodat de vertaling inhoudelijk correct is.
- Correcties: „Dit klinkt te wervend, graag zakelijker.“
- Context: geüploade eerdere versies, referentiedocumenten en eerdere vertalingen.
Dit is precies de kennis die bedrijven anders met veel moeite bijhouden in terminologiedatabases, stijlgidsen en Translation Memories. Medewerkers creëren deze kennis terloops, elke dag en vaak van hoge kwaliteit. Alleen: nergens wordt deze gezamenlijk opgeslagen.
Praktijkvoorbeeld: één onderdeel, drie vertalingen
Een middelgrote machinebouwer vertaalt met AI in drie afdelingen. Sales vertaalt offertes, de serviceafdeling onderhoudsinstructies en de technische redactie bedieningshandleidingen. Elke afdeling gebruikt eigen accounts en eigen prompts.
Het resultaat: hetzelfde onderdeel verschijnt in het Engels als „drive unit“, „motor module“ en „actuator“. De klant ontvangt een offerte, handleiding en service-instructie met drie verschillende benamingen voor één onderdeel. Elke afdeling heeft zijn AI iets corrects geleerd – maar elke afdeling iets anders.
De eenrichtingsstraat: kennis stroomt naar buiten, maar niet terug
Schaduw-AI werkt als een eenrichtingsweg: bedrijfskennis stroomt naar privé-AI-chats, maar niet terug naar het bedrijf. Medewerkers voegen vaktermen toe, corrigeren formuleringen en leveren referentiedocumenten aan. Daarmee verbeteren ze hun eigen resultaat. Maar zonder een gezamenlijk proces wordt deze kennis geen onderdeel van een centraal onderhouden kennisbank – wat vandaag in een persoonlijke chat wordt gecorrigeerd, is voor de collega bij de volgende opdracht niet beschikbaar. De gevolgen zijn in de dagelijkse praktijk zichtbaar:
Wat verloren gaat | Gevolg in de dagelijkse praktijk |
|---|---|
Correcties en vaktermen | Iedereen legt dezelfde begrippen opnieuw uit aan de AI. De kennis wordt twee- of zelfs driemaal opgebouwd. |
Goedgekeurde vertalingen | Vergelijkbare teksten worden steeds opnieuw vertaald en gecontroleerd, in plaats van bewezen formuleringen opnieuw te gebruiken. |
Eenduidige terminologie | Eenzelfde zaak wordt per afdeling anders genoemd – tegenover klanten, overheidsinstanties en partners. |
Ervaringskennis | Wanneer iemand het bedrijf verlaat, verdwijnt de in maanden opgebouwde taalkennis samen met het account. |
Traceerbaarheid | Niemand kan zeggen welke documentversie met welke richtlijnen is vertaald en door wie deze is gecontroleerd. |
Het klassieke probleem van kennismanagement wordt hierdoor versterkt. Vroeger lag kennis ongebruikt in de hoofden van mensen. Tegenwoordig wordt deze actief opgeschreven – maar op een plek waartoe het bedrijf geen systematische toegang heeft.
Vrij naar de bekende uitspraak: Als bedrijven wisten wat hun medewerkers AI al hebben geleerd, zouden ze de basis voor een uniforme bedrijfstaal allang in handen hebben gehad.
En de gegevensbescherming? De andere kant van dezelfde medaille
Ditzelfde eenrichtingsverkeer heeft een tweede kant: samen met de kennis verlaten ook gegevens het bedrijf. Bevat een document persoonsgegevens, dan geldt de AVG. Als een externe dienst als verwerker wordt ingezet, is in principe een overeenkomst volgens artikel 28 AVG vereist. Daar komen bedrijfsgeheimen en vertrouwelijkheidsverplichtingen tegenover klanten bij, die onafhankelijk van het al dan niet aanwezig zijn van persoonsgegevens gelden.
Persoonlijke AI-accounts zijn daarom doorgaans geen geschikte oplossing voor vertrouwelijke of persoonsgebonden bedrijfsdocumenten. Zakelijke aanbiedingen bieden meer controle: OpenAI gebruikt gegevens uit ChatGPT Business en Enterprise bijvoorbeeld standaard niet voor modeltraining en stelt een aanvulling op de verwerkersovereenkomst beschikbaar (OpenAI Enterprise-privacy). Maar ook dan geldt:
Belangrijk: „Geen modeltraining“, „geen opslag“ en „verwerking uitsluitend in de EU“ zijn drie verschillende uitspraken. Bij ChatGPT Business bepaalt de gekozen regio bijvoorbeeld waar inhoud wordt opgeslagen – niet per se waar elke verwerkingsstap plaatsvindt (OpenAI: opslaglocatie bij ChatGPT Business).
Een verwerkersovereenkomst is een belangrijke voorwaarde, maar geen volledig bewijs. De rechtsgrond, gegevensminimalisatie, doorgifte naar derde landen en, indien nodig, een gegevensbeschermingseffectbeoordeling blijven de verantwoordelijkheid van het bedrijf. Hoe bedrijven de regels hiervoor opstellen, beschrijven we uitgebreid in ons artikel AI-vertaling in het bedrijf: Governance in vier stappen.
In vijf stappen kennis terughalen
Schaduw-AI ontstaat omdat de privéchat sneller en gemakkelijker is dan de officiële weg. Alleen verboden helpen weinig: volgens IW zouden die vooral betrokken medewerkers treffen. Effectiever is een officiële weg die beter werkt dan de privéchat.
- Gebruik zichtbaar maken – zonder algemene verdenking. Vraag welke afdelingen met AI vertalen, om welke teksten, talen en volumes het gaat en welke prompts hun waarde hebben bewezen. Het doel is begrijpen, niet controleren.
- Bestaande taalkennis verzamelen. Woordenlijsten, beproefde instructies, goedgekeurde vertalingen en stijlgidsen zijn vaak al verspreid over de afdelingen aanwezig. Ze vormen de basis voor een gemeenschappelijke grondslag.
- Een goedgekeurde omgeving bieden die overtuigt. Die moet minstens zo eenvoudig zijn als de privéchat en meer bieden: betere resultaten, omdat de kennis van het bedrijf al is ingebouwd.
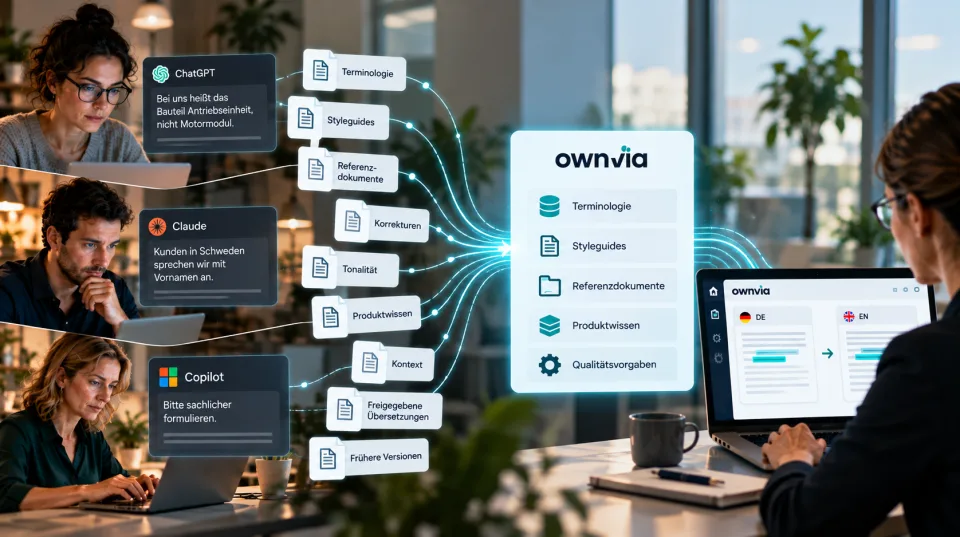
- Kennis centraal onderhouden en gericht toepassen. Terminologie, Translation Memories en richtlijnen worden eenmalig onderhouden en aan de betreffende opdracht toegewezen. Goedgekeurde correcties en vertalingen kunnen worden opgenomen in de gemeenschappelijke kennisbasis en bij toekomstige opdrachten opnieuw worden gebruikt. Zo verandert de eenrichtingsstraat geleidelijk in een kringloop.
- Controle, goedkeuring en AI-competentie regelen. Leg vast welke teksten inhoudelijk worden gecontroleerd en wie goedkeuring verleent, en train medewerkers praktijkgericht. Dit ondersteunt tegelijkertijd de verplichting uit Artikel 4 AI Act om maatregelen te nemen ter bevordering van AI-competentie.
Hoe ownvia de taalkennis in het bedrijf behoudt
ownvia is de AI-infrastructuur voor professionele vertaalprocessen. Het uitgangspunt: uw taal en uw kennis blijven de constante, terwijl de technologie zich met ownvia verder ontwikkelt. In plaats van in privéchats te verdwijnen, groeit de taalkennis op één plek waartoe alle bevoegde personen toegang hebben.
Kennis opslaan is niet hetzelfde als kennis in de juiste context toepassen. Een centrale kennisbasis alleen is niet voldoende. Een opdracht voor een machinebesturing vereist andere vaktermen en referentieteksten dan een marketingbrochure. Daarom moet de relevante bedrijfskennis gericht aan de betreffende opdracht worden toegewezen. Pas dan houdt de AI rekening met de juiste informatie, zonder te worden belast met tegenstrijdige of irrelevante richtlijnen. Precies daarvoor zijn er in ownvia de Translation Templates.
Probleem van schaduw-AI | Antwoord in ownvia |
|---|---|
Vakbegrippen worden steeds opnieuw uitgelegd | Terminologie wordt centraal beheerd en meegenomen bij opdrachten waaraan deze is gekoppeld. |
Goedgekeurde vertalingen blijven ongebruikt | Vertaalgeheugens maken beproefde formuleringen herbruikbaar. |
Instructies zitten in de prompts van individuen | Vertaaltemplates bundelen stijlgidsen, referentiekennis en instructies voor terugkerende taken. |
Product- en vakkennis is verspreid | Bedrijfskennis en documentcontext vloeien gericht in de vertaling. |
Controle hangt van het toeval af | Een Translate Agent vertaalt, een afzonderlijke QA Agent controleert en geeft aanwijzingen, zonder de tekst zelf te wijzigen. In de ownEDITOR controleren mensen de tekst en keuren deze goed (human-in-the-loop). |
De privéchat is handiger | De Translation Chat biedt het vertrouwde chatformat – met de kennis van het bedrijf op de achtergrond. |
Eilandoplossingen naast bestaande tools | De ownvia AI Translation Provider integreert het platform in Trados Studio; daarnaast zijn er een API en XLIFF. |
Het verschil met de algemene chatassistent ligt niet in het feit dat deze geen glossaria of stijlgidsen zou kunnen verwerken. Doorslaggevend is of de kennis centraal wordt beheerd, bij elke opdracht consistent wordt toegepast en aan gedefinieerde controlestappen is gekoppeld. In 2026 werd ownvia opgenomen in de Slator-lijst „Language AI 50 Under 50“.
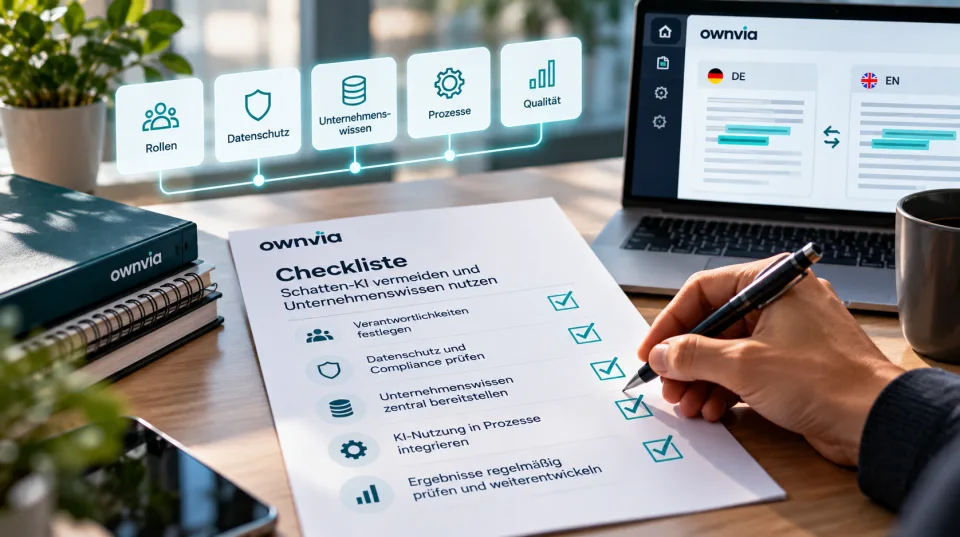
Checklist: Blijft uw taalkennis in de onderneming?
- We weten welke AI-tools medewerkers voor vertalingen gebruiken.
- Beproefde instructies en glossaria uit de afdelingen zijn verzameld.
- Verplichte terminologie wordt centraal beheerd en automatisch toegepast.
- Goedgekeurde vertalingen worden systematisch hergebruikt.
- Er is een vastgesteld proces waarmee gecontroleerde en goedgekeurde correcties in de gezamenlijke basis worden opgenomen.
- Het is geregeld welke documenten met welke toepassingen mogen worden verwerkt.
- Contractuele en privacyrechtelijke vereisten zijn gecontroleerd.
- Controle- en goedkeuringsstappen voor kwaliteitskritische teksten zijn vastgelegd en medewerkers zijn geschoold.
Hoe meer punten openstaan, des te meer taalkennis uw onderneming dagelijks opbouwt – en vervolgens weer verliest. De checklist dient ter oriëntatie en vervangt geen privacy- of juridische toetsing.
Conclusie: Schaduw-AI is een signaal, geen vijand
Dat medewerkers met AI vertalen, is in eerste instantie goed nieuws. Het laat zien dat er behoefte is, dat medewerkers initiatief nemen en dat er dagelijks veel nieuwe taalkennis ontstaat. Het probleem is niet het gebruik, maar het feit dat deze kennis in de privéchat eindigt en gegevens ongecontroleerd het bedrijf verlaten.
Bedrijven die deze kennis systematisch bruikbaar maken, kunnen privacyrisico's verminderen en een uniforme bedrijfstaal ontwikkelen die zich voortdurend verder ontwikkelt door gecontroleerde en goedgekeurde vertalingen.
De doorslaggevende vraag is daarom niet: „Mogen onze medewerkers met AI vertalen?” Maar: „Hoe zorgen we ervoor dat wat zij de AI leren, het hele bedrijf ten goede komt?”
Praat met ons over uw vertaalproces – wij laten u ownvia zien in een demo.
Veelgestelde vragen over schaduw-AI bij vertalingen
Wat is schaduw-AI bij vertalingen?
Schaduw-AI verwijst naar het gebruik van AI-tools buiten de toepassingen die door het bedrijf worden aangeboden of goedgekeurd. Bij vertalingen gaat het meestal om het vertalen van zakelijke documenten via persoonlijke ChatGPT-accounts of andere particuliere AI-diensten.
Waarom is schaduw-AI een kennisprobleem?
Medewerkers leren de AI tijdens het vertalen vaktermen, tone of voice en productkennis. Zonder een gezamenlijk proces wordt deze kennis geen onderdeel van een centraal onderhouden kennisbestand. Collega's kunnen er geen gebruik van maken, het bedrijf kan de kennis niet onderhouden en bij personeelswisselingen gaat deze verloren.
Moeten bedrijven privégebruik van AI verbieden?
Een verbod alleen lost het probleem zelden op, omdat de behoefte blijft bestaan. Het Institut der deutschen Wirtschaft concludeert dat een puur verbod vooral betrokken medewerkers zou treffen. Effectiever is een goedgekeurde oplossing die minstens zo eenvoudig is als de privéchat en dankzij ingebouwde bedrijfskennis betere resultaten oplevert.
Voldoet ChatGPT voor vertalingen aan de AVG?
Een algemeen antwoord is niet mogelijk. Zakelijke aanbiedingen met een verwerkersovereenkomst en uitgeschakelde modeltraining creëren belangrijke voorwaarden. Persoonlijke accounts zijn doorgaans niet geschikt voor vertrouwelijke of persoonsgegevens bevattende bedrijfsdocumenten.
Is het voldoende om training met mijn gegevens uit te schakelen?
Nee. Het uitschakelen heeft alleen betrekking op het gebruik voor modeltraining. Vragen over rechtsgrondslag, vertrouwelijkheid, opslaglocatie en toegang blijven bestaan – evenals het kennisprobleem.
Hoe blijft de terminologie bij AI-vertalingen uniform?
Door vaktermen centraal te onderhouden en aan de betreffende vertaalopdracht toe te wijzen, in plaats van ze in individuele prompts uit te leggen. Translation Memories zorgen er bovendien voor dat goedgekeurde formuleringen opnieuw worden gebruikt.
Wat vereist de AI Act bij AI-vertalingen?
Artikel 4 van de AI Act verplicht bedrijven maatregelen te nemen ter bevordering van de AI-geletterdheid van hun medewerkers. Sinds de wijziging door Verordening (EU) 2026/1744 van 27 juli 2026 hoeven zij daarbij geen specifiek competentieniveau te garanderen. Praktijkgerichte trainingen over de mogelijkheden en beperkingen van AI-vertalingen vormen een zinvolle bouwsteen.