Note de transparence : ownvia est un produit de SATRI Consulting. Cet article est fourni à des fins d’information spécialisée et ne constitue pas un conseil juridique.
Avec l’IA générative, la phrase prend un nouveau sens. Chaque jour, les collaborateurs traduisent des offres, des modes d’emploi et des e-mails avec ChatGPT et d’autres outils d’IA. Ce faisant, ils apprennent à l’IA comment leur entreprise s’exprime : quels termes techniques s’appliquent, quel ton convient au client et comment s’appelle un produit. Cependant, ces connaissances restent généralement dans l’historique personnel des conversations et n’intègrent pas une base de connaissances commune.
La réponse en bref : L’IA fantôme dans les traductions n’est pas seulement un risque pour la protection des données, mais surtout un problème de connaissances. Les connaissances de l’entreprise s’échappent vers des conversations privées avec l’IA, mais ne reviennent pas. Chaque correction, chaque terme technique et chaque formulation réussie reste chez le collaborateur concerné. Les interdictions résolvent rarement le problème. Il est plus efficace de disposer d’un environnement commun dans lequel la terminologie, les traductions validées et les consignes sont gérées de manière centralisée et bénéficient à tous.
Quelle est la fréquence de l’IA fantôme dans les entreprises ?
L’IA fantôme désigne l’utilisation d’outils d’IA en dehors des applications fournies ou autorisées par une entreprise. Deux études récentes montrent qu’elle fait partie du quotidien des entreprises allemandes.
Étude | Résultat |
|---|---|
Enquête auprès des entreprises de Bitkom, publiée en octobre 2025, 604 entreprises comptant au moins 20 salariés | Dans 8 % des entreprises, l’utilisation d’outils d’IA privés est largement répandue ; dans 17 % supplémentaires, des cas isolés sont constatés, et 17 % la soupçonnent sans en avoir la certitude. |
Enquête auprès des salariés menée par l’Institut der deutschen Wirtschaft, mars/avril 2026, près de 5 000 salariés | 29,1 % des salariés qui utilisent l’IA dans leur travail ont également recours à des outils que leur employeur n’a pas mis à leur disposition. |
Au total, 42 % des entreprises interrogées par Bitkom déclarent donc utiliser une IA fantôme ou la soupçonnent. « Non mis à disposition » ne signifie pas automatiquement « interdit ». Cela montre toutefois que l’utilisation réelle de l’IA et les processus officiels divergent.
Un résultat de l’IW surprend : l’IA fantôme est la plus fréquente là où les employeurs encouragent le développement des compétences en IA : 44,5 % des salariés bénéficiant d’un soutien important utilisent des outils non mis à disposition, contre 21,3 % de ceux qui ne perçoivent aucun soutien. L’IW parle d’un déficit de mise à disposition : la volonté des salariés progresse plus rapidement que l’offre officielle. Selon Bitkom, seules 26 % des entreprises mettent une IA générative à la disposition de leurs salariés. L’IA fantôme est donc moins un signe de non-respect des règles qu’un signe de besoin non satisfait.
Cela pèse particulièrement lourd pour les traductions. Contrairement à une courte requête de recherche, le document complet est généralement transmis à l’IA, avec les connaissances spécialisées, les données clients et les détails sur les produits.
Ce que les salariés apprennent chaque jour à l’IA
Traduire avec l’IA ne consiste pas seulement à saisir du texte. De bons résultats ne sont obtenus que lorsque les salariés expliquent à l’IA comment leur entreprise s’exprime. Par « apprendre », on entend ici les instructions et le contexte fournis dans le chat concerné, et non l’entraînement du modèle d’IA. Instructions typiques du quotidien professionnel :
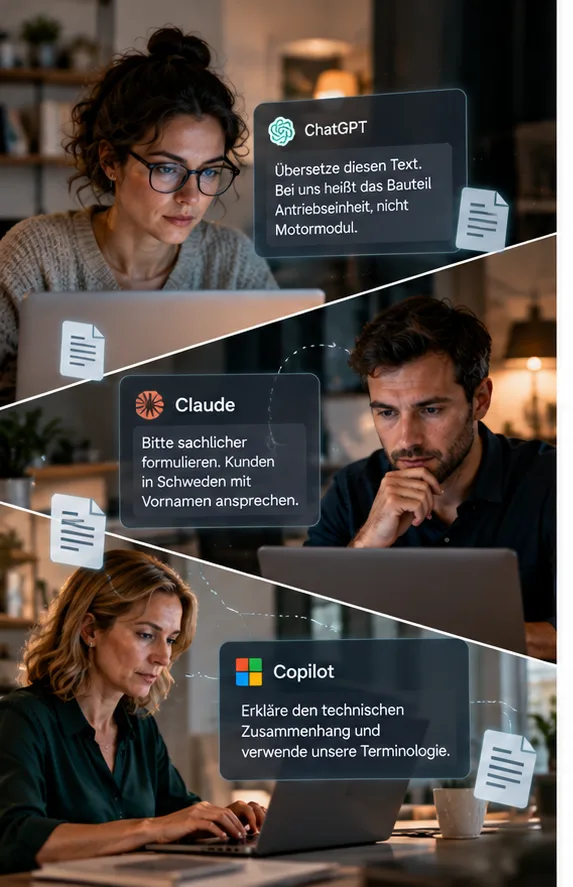
- Terminologie : « Chez nous, ce composant s'appelle unité d'entraînement, pas module moteur. »
- Tonalité : « En Suède, nous nous adressons aux clients par leur prénom. »
- Connaissances produits : Explications des liens techniques afin que la traduction soit correcte sur le plan technique.
- Corrections : « Cela paraît trop publicitaire, veuillez adopter un ton plus factuel. »
- Contexte : versions antérieures téléchargées, documents de référence et traductions précédentes.
C'est exactement le type de connaissances que les entreprises entretiennent habituellement à grands frais dans des bases terminologiques, des guides de style et des mémoires de traduction. Les collaborateurs les produisent au passage, chaque jour et souvent avec une grande qualité. Seulement voilà : elles ne sont stockées nulle part de manière collective.
Exemple pratique : un composant, trois traductions
Un fabricant de machines de taille moyenne traduit des contenus avec l'IA dans trois services. Le service commercial traduit les offres, le service après-vente les consignes de maintenance et la rédaction technique les notices d'utilisation. Chaque service utilise ses propres comptes et ses propres prompts.
Résultat : le même composant apparaît en anglais sous les formes « drive unit », « motor module » et « actuator ». Le client reçoit une offre, une notice et une consigne de service contenant trois termes différents pour une même pièce. Chaque service a appris quelque chose de correct à son IA, mais chacun lui a appris quelque chose de différent.
Le sens unique : les connaissances circulent vers l'extérieur, mais ne reviennent pas
L’IA fantôme fonctionne comme une voie à sens unique : les connaissances de l’entreprise affluent vers les chats IA privés, mais ne retournent pas dans l’entreprise. Les collaborateurs ajoutent des termes spécialisés, corrigent des formulations et fournissent des documents de référence. Ils améliorent ainsi leur propre résultat. Mais sans processus commun, ces connaissances n’intègrent pas une base de connaissances gérée de manière centralisée – ce qui est corrigé aujourd’hui dans un chat personnel n’est pas disponible pour le collègue lors de la prochaine mission. Les conséquences se manifestent au quotidien :
Ce qui se perd | Conséquence au quotidien |
|---|---|
Corrections et termes spécialisés | Chaque personne réexplique les mêmes termes à l’IA. Les connaissances sont ainsi élaborées deux ou trois fois. |
Traductions approuvées | Des textes similaires sont constamment retraduits et vérifiés, au lieu de réutiliser des formulations éprouvées. |
Terminologie uniforme | La même chose est désignée différemment selon les services — vis-à-vis des clients, des autorités et des partenaires. |
Connaissances issues de l’expérience | Lorsqu’une personne quitte l’entreprise, les connaissances linguistiques qu’elle a accumulées pendant des mois disparaissent avec son compte. |
Traçabilité | Personne ne peut dire quelle version du document a été traduite avec quelles consignes et vérifiée par qui. |
Le problème classique de la gestion des connaissances s’en trouve aggravé. Autrefois, les connaissances restaient inutilisées dans les esprits. Aujourd’hui, elles sont activement consignées, mais dans un endroit auquel l’entreprise n’a pas accès de manière systématique.
Pour reprendre librement une phrase célèbre : Si les entreprises savaient ce que leurs collaborateurs ont déjà appris à l’IA, elles disposeraient depuis longtemps des bases d’un langage d’entreprise uniforme.
Et la protection des données ? L’autre face de la même médaille
Cette même voie à sens unique a une autre face : avec les connaissances, les données quittent également l’entreprise. Si un document contient des données à caractère personnel, le RGPD s’applique. Lorsqu’un service externe est utilisé en tant que sous-traitant, un contrat conforme à l’article 28 du RGPD est en principe nécessaire. À cela s’ajoutent les secrets d’affaires et les obligations de confidentialité envers les clients, qui s’appliquent indépendamment de la présence de données à caractère personnel.
Les comptes d’IA personnels ne constituent donc généralement pas une solution adaptée pour les documents d’entreprise confidentiels ou contenant des données à caractère personnel. Les offres professionnelles offrent davantage de contrôle : OpenAI, par exemple, n’utilise par défaut pas les données de ChatGPT Business et Enterprise pour entraîner ses modèles et fournit un avenant relatif au traitement des données (Protection des données OpenAI Enterprise). Mais même dans ce cas :
Important : « aucun entraînement des modèles », « aucune conservation » et « traitement exclusivement dans l’UE » sont trois affirmations différentes. Dans le cas de ChatGPT Business, par exemple, la région sélectionnée détermine le lieu de stockage des contenus, mais pas nécessairement chaque étape du traitement (OpenAI : lieu de stockage dans ChatGPT Business).
Un contrat de sous-traitance constitue une condition importante, mais ne fournit pas une preuve complète. La base juridique, la minimisation des données, les transferts vers des pays tiers et, le cas échéant, une analyse d’impact relative à la protection des données restent de la responsabilité de l’entreprise. Nous décrivons en détail dans notre article Traduction par IA en entreprise comment les entreprises peuvent mettre en place les règles correspondantes : Gouvernance en quatre étapes.
Récupérer les connaissances en cinq étapes
L’IA fantôme apparaît parce que le chat privé est plus rapide et plus pratique que la voie officielle. Les interdictions seules sont peu efficaces : selon l’IW, elles toucheraient avant tout les collaborateurs engagés. Une voie officielle qui fonctionne mieux que le chat privé est plus efficace.
- Rendre l’utilisation visible – sans suspicion généralisée. Demandez quels services utilisent l’IA pour traduire, quels textes, quelles langues et quels volumes sont concernés, et quels prompts ont fait leurs preuves. L’objectif est de comprendre, pas de contrôler.
- Recueillir les connaissances linguistiques existantes. Les glossaires, les instructions éprouvées, les traductions approuvées et les guides de style sont souvent déjà dispersés dans les services. Ils constituent la base d’un socle commun.
- Mettre à disposition un environnement approuvé qui convainc. Il doit être au moins aussi simple que le chat privé et offrir davantage : de meilleurs résultats, parce que les connaissances de l’entreprise y sont déjà intégrées.
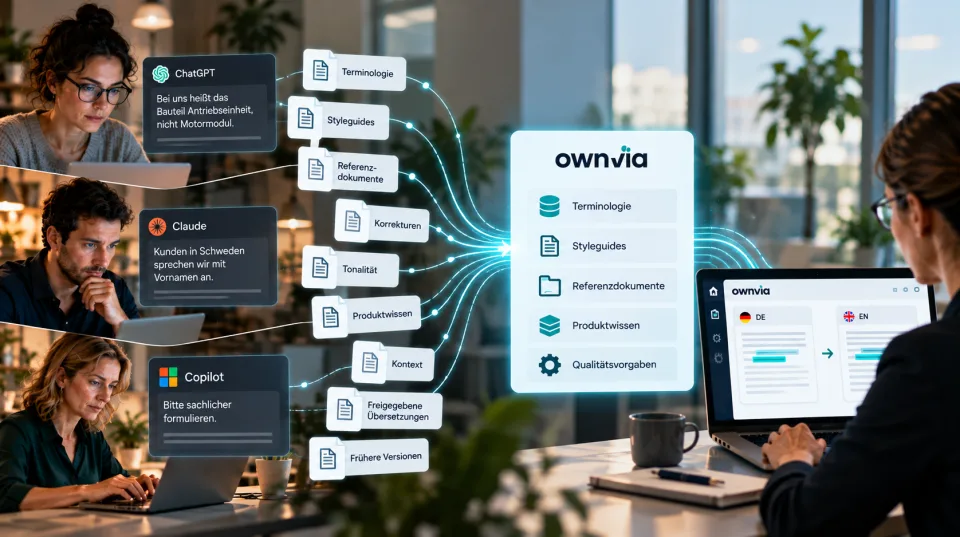
- Gérer les connaissances de manière centralisée et les appliquer de façon ciblée. La terminologie, les mémoires de traduction et les directives sont gérées une seule fois, puis associées à la mission concernée. Les corrections et traductions approuvées peuvent être intégrées à la base de connaissances commune et réutilisées pour les futures missions. Ainsi, le processus à sens unique devient progressivement un cycle.
- Réglementer la vérification, l’approbation et les compétences en IA. Définissez quels textes doivent faire l’objet d’une vérification spécialisée et qui les approuve, puis formez les collaborateurs de manière pratique. Cela contribue également à satisfaire à l’obligation prévue par l’article 4 de l’AI Act, qui consiste à prendre des mesures pour promouvoir les compétences en IA.
Comment ownvia préserve les connaissances linguistiques au sein de l’entreprise
ownvia est l’infrastructure d’IA dédiée aux processus de traduction professionnels. L’idée centrale : votre langue et vos connaissances restent la constante, tandis que la technologie évolue avec ownvia. Au lieu de se perdre dans des chats privés, les connaissances linguistiques s’enrichissent en un lieu auquel toutes les personnes autorisées peuvent accéder.
Enregistrer les connaissances ne signifie pas les appliquer dans le bon contexte. Une base de connaissances centralisée ne suffit pas à elle seule. Une mission portant sur la commande d’une machine nécessite d’autres termes spécialisés et textes de référence qu’une brochure marketing. C’est pourquoi les connaissances pertinentes de l’entreprise doivent être associées de manière ciblée à la mission concernée. Ce n’est qu’alors que l’IA prend en compte les informations appropriées, sans être encombrée par des directives contradictoires ou non pertinentes. C’est précisément à cela que servent les Translation Templates dans ownvia.
Problème de l’IA fantôme | Réponse dans ownvia |
|---|---|
Les termes techniques sont réexpliqués à chaque fois | La terminologie est gérée de manière centralisée et prise en compte pour les tâches auxquelles elle est attribuée. |
Les traductions approuvées restent inutilisées | Translation Memories rendent réutilisables les formulations éprouvées. |
Les consignes sont intégrées aux prompts individuels | Modèles de traduction regroupent les guides de style, les connaissances de référence et les instructions pour les tâches récurrentes. |
Les connaissances produits et spécialisées sont dispersées | Les connaissances de l’entreprise et le contexte des documents sont intégrés de manière ciblée dans la traduction. |
La vérification dépend du hasard | Un Translate Agent traduit, un QA Agent séparé vérifie et fournit des indications, sans modifier lui-même le texte. Dans ownEDITOR, des personnes vérifient et valident (Human-in-the-loop). |
Le chat privé est plus pratique | Le Translation Chat offre le format de chat familier, avec les connaissances de l’entreprise en arrière-plan. |
Des solutions isolées à côté des outils existants | Le ownvia AI Translation Provider intègre la plateforme à Trados Studio, avec en complément une API et XLIFF. |
La différence avec l’assistant conversationnel généraliste ne réside pas dans le fait qu’il ne pourrait pas traiter des glossaires ou des guides de style. L’essentiel est de savoir si les connaissances sont gérées de manière centralisée, appliquées de façon cohérente à chaque mission et associées à des étapes de contrôle définies. En 2026, ownvia a été intégrée à la liste Slator « Language AI 50 Under 50 ».
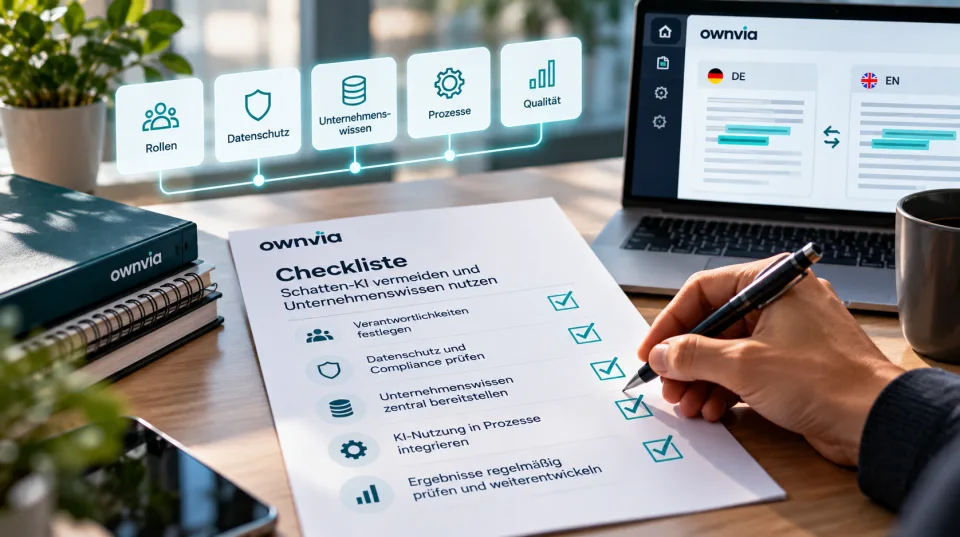
Checklist : vos connaissances linguistiques restent-elles au sein de l’entreprise ?
- Nous savons quels outils d’IA les collaborateurs utilisent pour les traductions.
- Les instructions éprouvées et les glossaires des différents services sont rassemblés.
- La terminologie obligatoire est gérée de manière centralisée et appliquée automatiquement.
- Les traductions validées sont systématiquement réutilisées.
- Un processus défini permet d’intégrer les corrections vérifiées et validées dans la base commune.
- Il est défini quels documents peuvent être traités avec quelles applications.
- Les conditions contractuelles et les exigences en matière de protection des données ont été vérifiées.
- Les étapes de contrôle et de validation pour les textes critiques en matière de qualité sont définies, et les collaborateurs sont formés.
Plus le nombre de points non résolus est élevé, plus votre entreprise élabore chaque jour des connaissances linguistiques — et les perd ensuite. Cette checklist sert de guide et ne remplace ni un examen relatif à la protection des données ni une vérification juridique.
Conclusion : l’IA fantôme est un signal, pas un ennemi
Que des collaborateurs traduisent avec l’IA est d’abord une bonne nouvelle. Cela montre qu’il existe un besoin, une initiative personnelle et de nombreuses connaissances linguistiques qui se développent chaque jour. Le problème n’est pas l’utilisation de l’IA, mais le fait que ces connaissances restent dans un chat privé et que des données quittent l’entreprise de manière incontrôlée.
Les entreprises qui rendent ces connaissances systématiquement exploitables peuvent réduire les risques liés à la protection des données et établir un langage d’entreprise uniforme, qui évolue continuellement grâce à des traductions vérifiées et approuvées.
La question décisive n’est donc pas : « Nos collaborateurs ont-ils le droit de traduire avec l’IA ? » Mais plutôt : « Comment faire en sorte que ce qu’ils apprennent à l’IA profite à l’ensemble de l’entreprise ? »
Questions fréquentes sur l’IA fantôme dans les traductions
Qu’est-ce que l’IA fantôme dans les traductions ?
L’IA fantôme désigne l’utilisation d’outils d’IA en dehors des applications mises à disposition ou approuvées par l’entreprise. Dans le domaine de la traduction, il s’agit généralement de traduire des documents professionnels via des comptes ChatGPT personnels ou d’autres services d’IA privés.
Pourquoi l’IA fantôme pose-t-elle un problème de connaissances ?
Lorsqu’ils traduisent, les collaborateurs apprennent à l’IA des termes spécialisés, un ton et des connaissances sur les produits. Sans processus commun, ces connaissances n’intègrent pas une base de connaissances gérée de manière centralisée. Les collègues ne peuvent pas les utiliser, l’entreprise ne peut pas les entretenir et elles se perdent lors d’un changement de personnel.
Les entreprises devraient-elles interdire l’utilisation privée de l’IA ?
Une interdiction à elle seule résout rarement le problème, car le besoin demeure. L’Institut der deutschen Wirtschaft parvient à la conclusion que les interdictions générales toucheraient surtout les collaborateurs engagés. Il est plus efficace de proposer une solution approuvée, au moins aussi simple que le chat privé, et qui fournit de meilleurs résultats grâce aux connaissances intégrées de l’entreprise.
ChatGPT est-il conforme au RGPD pour les traductions ?
Il n’est pas possible de donner une réponse générale. Les offres professionnelles assorties d’un accord de traitement des données et d’un entraînement du modèle désactivé créent des conditions importantes. En règle générale, les comptes personnels ne sont pas adaptés aux documents d’entreprise confidentiels ou contenant des données à caractère personnel.
Suffit-il de désactiver l’entraînement avec mes données ?
Non. La désactivation concerne uniquement l’utilisation des données pour l’entraînement du modèle. Les questions relatives à la base juridique, à la confidentialité, au lieu de stockage et aux droits d’accès restent posées, tout comme le problème lié aux connaissances.
Comment maintenir une terminologie homogène dans les traductions avec l’IA ?
En gérant les termes spécialisés de manière centralisée et en les associant à la demande de traduction concernée, plutôt qu’en les expliquant dans des prompts individuels. Les Translation Memories garantissent en outre la réutilisation des formulations approuvées.
Que prévoit l’AI Act pour les traductions avec l’IA ?
L’article 4 de l’AI Act oblige les entreprises à prendre des mesures pour favoriser les compétences de leurs collaborateurs en matière d’IA. Depuis la modification apportée par le règlement (UE) 2026/1744 du 27 juillet 2026, elles ne sont toutefois plus tenues de garantir un niveau de compétences précis. Des formations pratiques sur les possibilités et les limites des traductions par IA constituent un élément pertinent.