Note de transparence : ownvia est un produit de SATRI Consulting. Cet article est destiné à fournir des informations spécialisées et ne constitue pas un conseil juridique.
Avec l’IA générative, la phrase prend un nouveau sens. Chaque jour, les collaborateurs traduisent des offres, des modes d’emploi et des e-mails avec ChatGPT et d’autres outils d’IA. Ce faisant, ils apprennent à l’IA comment leur entreprise s’exprime : quels termes techniques s’appliquent, quel ton convient au client et comment s’appelle un produit. Toutefois, ces connaissances restent généralement dans l’historique personnel des conversations et ne deviennent pas partie intégrante d’une base de connaissances commune.
La réponse en bref : L’IA fantôme dans les traductions fait qu’une entreprise s’exprime différemment dans chaque service. Les termes techniques, les corrections et les formulations réussies sont créés dans des conversations privées avec l’IA et y restent. À cela s’ajoutent des questions de protection des données et de confidentialité. Une solution consiste à disposer d’un environnement commun dans lequel la terminologie, les traductions approuvées et les consignes sont gérées de manière centralisée et s’appliquent à chaque commande.
Quelle est la fréquence de l’IA fantôme dans les entreprises ?
L’IA fantôme désigne l’utilisation d’outils d’IA en dehors des applications mis à disposition ou approuvées par une entreprise. Deux enquêtes récentes montrent qu’elle fait partie du quotidien des entreprises allemandes.
Enquête | Résultat |
|---|---|
Enquête de Bitkom auprès des entreprises, publiée en octobre 2025, 604 entreprises comptant au moins 20 salariés | Dans 8 % des entreprises, l’utilisation d’outils d’IA privés est très répandue ; dans 17 % supplémentaires, des cas isolés sont recensés, et 17 % la soupçonnent sans en avoir la certitude. |
Enquête auprès des salariés menée par l’Institut der deutschen Wirtschaft, mars/avril 2026, près de 5 000 salariés | 29,1 % des salariés qui utilisent l’IA dans le cadre professionnel ont également recours à des outils que leur employeur n’a pas mis à leur disposition. |
Au total, 42 % des entreprises interrogées par Bitkom signalent ou soupçonnent donc l’utilisation d’une IA fantôme. « Non mis à disposition » ne signifie pas automatiquement « interdit ». Cela montre toutefois que l’utilisation réelle de l’IA et les processus officiels divergent.
Un constat de l’Institut der deutschen Wirtschaft surprend : l’IA fantôme est la plus fréquente là où les employeurs favorisent le développement des compétences en IA – 44,5 % des salariés bénéficiant d’un fort soutien utilisent des outils non mis à disposition, contre 21,3 % de ceux qui ne perçoivent aucun soutien. L’Institut der deutschen Wirtschaft parle d’un déficit de mise à disposition : la volonté des salariés progresse plus rapidement que l’offre officielle. Selon Bitkom, seules 26 % des entreprises mettent une IA générative à la disposition de leurs salariés. L’IA fantôme est donc moins le signe d’une infraction aux règles que celui d’un besoin non satisfait.
Pour les traductions, le problème est particulièrement important. Contrairement à une courte requête de recherche, c’est généralement le document complet qui est transmis à l’IA – avec le savoir-faire, les données clients et les détails sur les produits.
Ce que les salariés apprennent chaque jour à l’IA
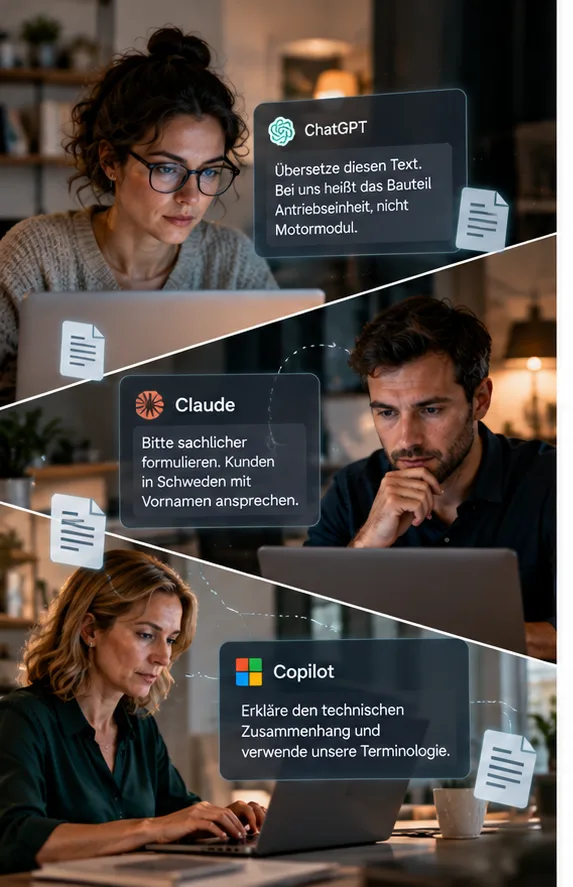
Une personne qui traduit avec l’IA ne saisit pas seulement du texte. De bons résultats ne sont obtenus que lorsque les salariés expliquent à l’IA comment leur entreprise s’exprime. Par « apprendre », on entend ici les instructions et le contexte fournis dans le chat concerné, et non l’entraînement du modèle d’IA. Exemples d’instructions typiques du quotidien professionnel :
- Terminologie : « Chez nous, ce composant s’appelle unité d’entraînement, et non module moteur. »
- Tonalité : « En Suède, nous nous adressons aux clients par leur prénom. »
- Connaissances produits : Explications des relations techniques afin que la traduction soit correcte sur le plan spécialisé.
- Corrections : « Cela semble trop publicitaire, veuillez adopter un ton plus factuel. »
- Contexte : versions précédentes téléchargées, documents de référence et traductions antérieures.
C’est exactement le type de connaissances que les entreprises entretiennent habituellement, au prix de nombreux efforts, dans des bases terminologiques, des guides de style et des Translation Memories. Les collaborateurs les produisent au quotidien, souvent en parallèle de leur travail et avec un niveau de qualité élevé. Seulement voilà : elles ne sont nulle part conservées collectivement.
Exemple pratique : un composant, trois traductions
Un fabricant de machines de taille moyenne utilise l’IA pour traduire dans trois services. Le service commercial traduit les offres, le service après-vente les consignes de maintenance et la rédaction technique les manuels d’utilisation. Chaque service utilise ses propres comptes et ses propres prompts.
Résultat : le même composant apparaît en anglais sous les appellations « drive unit », « motor module » et « actuator ». Le client reçoit une offre, un manuel et une consigne de service contenant trois termes différents pour une même pièce. Chaque service a appris quelque chose de juste à son IA, mais chacun lui a appris quelque chose de différent.
La voie à sens unique : les connaissances circulent vers l’extérieur, mais ne reviennent pas
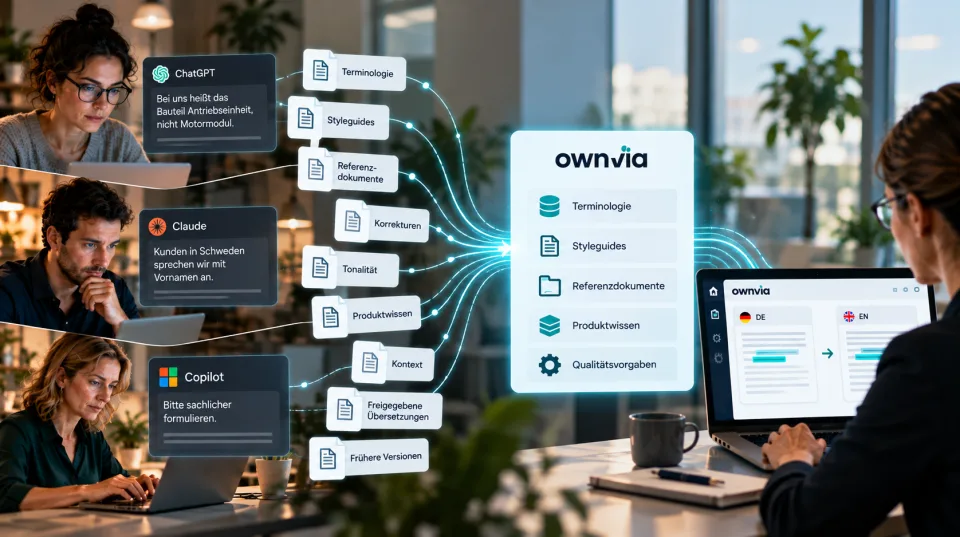
L’IA fantôme fonctionne comme une voie à sens unique : les connaissances de l’entreprise affluent dans les chats IA privés, mais ne reviennent pas dans l’entreprise. Les collaborateurs ajoutent des termes techniques, corrigent des formulations et mettent à disposition des documents de référence. Ils améliorent ainsi leur propre résultat. Mais sans processus commun, ces connaissances ne font pas partie d’une base de connaissances gérée de manière centralisée – ce qui est corrigé aujourd’hui dans un chat personnel n’est pas disponible pour le collègue lors de sa prochaine mission. Les conséquences se manifestent au quotidien :
Ce qui se perd | Conséquence au quotidien |
|---|---|
Corrections et termes techniques | Quiconque définit un terme technique dans son chat ne le définit que pour lui-même. Les collègues utilisent d’autres termes ou clarifient à nouveau la même question. |
Traductions validées | Des textes similaires sont sans cesse retraduits et vérifiés, au lieu de réutiliser des formulations qui ont fait leurs preuves. |
Terminologie uniforme | Une même chose est désignée différemment selon les services – vis-à-vis des clients, des autorités et des partenaires. |
Savoir-faire acquis | Lorsqu’une personne quitte l’entreprise, les connaissances linguistiques qu’elle a accumulées pendant des mois disparaissent avec son compte. |
Traçabilité | Personne ne peut dire quelle version d’un document a été traduite selon quelles consignes et vérifiée par qui. |
Le paradoxe, c’est que les connaissances linguistiques sont aujourd’hui consignées de manière plus détaillée que jamais auparavant – terme par terme, correction après correction. Mais cela se fait à un endroit auquel l’entreprise n’a pas accès.
Et la protection des données ? L’autre face de la même médaille
La même impasse a un revers : avec les connaissances, des données quittent également l’entreprise. Si un document contient des données à caractère personnel, le RGPD s’applique. Lorsqu’un service externe est utilisé comme sous-traitant, un contrat au titre de l’article 28 du RGPD est en principe requis. S’y ajoutent les secrets d’affaires et les obligations de confidentialité envers les clients, qui s’appliquent indépendamment du caractère personnel des données.
Les comptes IA personnels ne constituent donc généralement pas une solution adaptée aux documents d’entreprise confidentiels ou contenant des données à caractère personnel. Les offres professionnelles offrent davantage de contrôle : OpenAI, par exemple, n’utilise par défaut pas les données de ChatGPT Business et Enterprise pour entraîner ses modèles et fournit un addendum relatif au traitement des données (OpenAI Enterprise-Datenschutz). Mais même dans ce cas :
Important : « pas d’entraînement des modèles », « pas de conservation » et « traitement exclusivement dans l’UE » sont trois affirmations différentes. Dans le cas de ChatGPT Business, par exemple, la région sélectionnée détermine le lieu de stockage des contenus – pas nécessairement chaque étape du traitement (OpenAI: Speicherort bei ChatGPT Business).
Un contrat de sous-traitance constitue une condition importante, mais ne constitue pas une preuve complète. La base juridique, la minimisation des données, les transferts vers des pays tiers et, le cas échéant, une analyse d’impact relative à la protection des données restent de la responsabilité de l’entreprise. Nous décrivons en détail dans notre article « Traduction par IA en entreprise : la gouvernance en quatre étapes.
Récupérer les connaissances en cinq étapes
L’IA fantôme apparaît parce que le chat privé est plus rapide et plus pratique que la voie officielle. Les interdictions seules sont peu efficaces : selon l’IW, elles toucheraient avant tout les salariés engagés. Une voie officielle qui fonctionne mieux que le chat privé est plus efficace.
- Rendre visible l’utilisation – sans suspicion généralisée. Demandez quelles équipes utilisent l’IA pour traduire, quels textes et quelles langues sont concernés, quelles quantités sont produites et quels prompts ont fait leurs preuves. L’objectif est de comprendre, pas de contrôler.
- Rassembler les connaissances linguistiques existantes. Les glossaires, les instructions éprouvées, les traductions approuvées et les guides de style sont souvent déjà dispersés dans les différents services. Ils constituent le socle d’une base commune.
- Mettre à disposition un environnement approuvé qui convainc. Il doit être au moins aussi simple que le chat privé et offrir davantage : de meilleurs résultats, car les connaissances de l’entreprise y sont déjà intégrées.
- Gérer centralement les connaissances et les appliquer de manière ciblée. La terminologie, les Translation Memories et les directives sont gérées une seule fois, puis associées à la mission concernée. Les corrections et traductions approuvées peuvent être intégrées à la base de connaissances commune et réutilisées pour les missions futures. Ainsi, le fonctionnement à sens unique devient progressivement un cycle.
- Réglementer la vérification, l’approbation et les compétences en IA. Définissez quels textes doivent faire l’objet d’une vérification spécialisée et qui donne l’approbation, puis formez les collaborateurs de manière pratique. Cela contribue également à respecter l’obligation découlant de l’article 4 de l’AI Act, qui impose de prendre des mesures pour promouvoir les compétences en IA.
Comment ownvia préserve les connaissances linguistiques dans l’entreprise
ownvia est l’infrastructure d’IA destinée aux processus de traduction professionnels. L’idée centrale : votre langue et vos connaissances restent la constante, tandis que la technologie évolue avec ownvia. Au lieu de se perdre dans des chats privés, les connaissances linguistiques se développent en un lieu auquel toutes les personnes autorisées peuvent accéder.
Stocker les connaissances ne signifie pas les appliquer dans le bon contexte. Une base de connaissances centrale ne suffit pas à elle seule. Une mission portant sur la commande d’une machine nécessite des termes spécialisés et des textes de référence différents de ceux d’une brochure marketing. Les connaissances pertinentes de l’entreprise doivent donc être associées de manière ciblée à la mission concernée. Ce n’est qu’alors que l’IA prend en compte les informations appropriées, sans être surchargée par des directives contradictoires ou non pertinentes. C’est précisément à cela que servent les Translation Templates dans ownvia.
Problème de l’IA fantôme | Réponse dans ownvia |
|---|---|
Les termes techniques doivent être réexpliqués encore et encore | La terminologie est gérée de manière centralisée et prise en compte pour les missions auxquelles elle est associée. |
Les traductions approuvées restent inutilisées | Les mémoires de traduction rendent les formulations éprouvées réutilisables. |
Les consignes sont dispersées dans les prompts de chacun | Les modèles de traduction regroupent les guides de style, les connaissances de référence et les instructions pour les tâches récurrentes. |
Les connaissances produits et spécialisées sont dispersées | Les connaissances de l’entreprise et le contexte documentaire sont intégrés de manière ciblée dans la traduction. |
La vérification dépend du hasard | Un Translate Agent traduit, un QA Agent séparé vérifie et fournit des indications, sans modifier lui-même le texte. Dans ownEDITOR, des personnes vérifient et valident (Human-in-the-loop). |
Le chat privé est plus pratique | Le Translation Chat propose le format de chat familier, avec les connaissances de l’entreprise en arrière-plan. |
Des solutions isolées à côté des outils existants | Le ownvia AI Translation Provider intègre la plateforme à Trados Studio, auxquels s’ajoutent une API et XLIFF. |
La différence avec l’assistant conversationnel généraliste ne tient pas au fait qu’il serait incapable de traiter des glossaires ou des guides de style. Ce qui compte, c’est de savoir si les connaissances sont gérées de manière centralisée, appliquées de façon cohérente à chaque mission et associées à des étapes de contrôle définies. En 2026, ownvia a été intégré à la liste « Language AI 50 Under 50 » de Slator.
Checklist : votre savoir linguistique reste-t-il dans l’entreprise ?
- Nous savons quels outils d’IA les collaborateurs utilisent pour les traductions.
- Les instructions éprouvées et les glossaires des différents services sont regroupés.
- La terminologie contraignante est gérée de manière centralisée et appliquée automatiquement.
- Les traductions approuvées sont systématiquement réutilisées.
- Un processus défini permet d’intégrer les corrections vérifiées et approuvées dans la base commune.
- Il est défini quels documents peuvent être traités avec quelles applications.
- Les conditions contractuelles et celles relatives à la protection des données ont été vérifiées.
- Les étapes de contrôle et d’approbation des textes critiques pour la qualité sont définies, et les collaborateurs sont formés.
Plus il reste de points en suspens, plus votre entreprise élabore chaque jour de savoir linguistique — et le reperd. La checklist sert de repère et ne remplace aucun examen relatif à la protection des données ou examen juridique.
Conclusion : l’IA fantôme est un signal, pas un ennemi
Le fait que les collaborateurs utilisent l’IA pour traduire est tout d’abord une bonne nouvelle. Cela montre qu’il existe un besoin, une initiative personnelle et de nombreuses connaissances linguistiques qui se développent chaque jour. Le problème n’est pas l’utilisation en elle-même, mais le fait que ces connaissances restent confinées aux chats privés et que des données quittent l’entreprise de manière incontrôlée.
Regrouper la terminologie, les consignes et les traductions validées en un seul endroit permet de réduire les risques liés à la protection des données et de créer un langage d’entreprise qui s’améliore avec chaque traduction vérifiée.
La question décisive n’est donc pas : « Nos collaborateurs ont-ils le droit de traduire avec l’IA ? » Mais plutôt : « Comment faire en sorte que ce qu’ils apprennent à l’IA profite à l’ensemble de l’entreprise ? »
Questions fréquentes sur l’IA fantôme dans les traductions
Qu’est-ce que l’IA fantôme dans les traductions ?
L’IA fantôme désigne l’utilisation d’outils d’IA en dehors des applications fournies ou approuvées par l’entreprise. Dans le contexte des traductions, il s’agit généralement de traduire des documents professionnels à l’aide de comptes ChatGPT personnels ou d’autres services d’IA privés.
Pourquoi les connaissances linguistiques se perdent-elles avec l’IA fantôme ?
Lorsqu’ils traduisent, les collaborateurs apprennent à l’IA des termes spécialisés, une tonalité et des connaissances sur les produits. Sans processus commun, ces connaissances n’intègrent pas une base de connaissances gérée de manière centralisée. Les collègues ne peuvent pas les utiliser, l’entreprise ne peut pas les entretenir et elles se perdent lors d’un changement de personnel.
Les entreprises devraient-elles interdire l’utilisation privée de l’IA ?
Une interdiction à elle seule résout rarement le problème, car le besoin demeure. L’Institut der deutschen Wirtschaft conclut que les interdictions pures et simples toucheraient principalement les collaborateurs les plus engagés. Une solution approuvée, au moins aussi simple que le chat privé et fournissant de meilleurs résultats grâce aux connaissances intégrées de l’entreprise, est plus efficace.
ChatGPT est-il conforme au RGPD pour les traductions ?
Il n’est pas possible de donner une réponse générale. Les offres professionnelles assorties d’un accord de sous-traitance et d’un entraînement du modèle désactivé créent des conditions importantes. En règle générale, les comptes personnels ne conviennent pas aux documents d’entreprise confidentiels ou contenant des données à caractère personnel.
Suffit-il de désactiver l’entraînement avec mes données ?
Non. La désactivation concerne uniquement l’utilisation des données pour l’entraînement du modèle. Les questions relatives à la base juridique, à la confidentialité, au lieu de stockage et aux accès restent posées, tout comme le problème lié aux connaissances.
Comment garantir une terminologie cohérente dans les traductions effectuées avec l’IA ?
En gérant les termes spécialisés de manière centralisée et en les associant à la mission de traduction concernée, plutôt qu’en les expliquant dans des prompts individuels. Les Translation Memory permettent en outre de réutiliser les formulations validées.
Que prévoit l’AI Act pour les traductions par IA ?
L’article 4 de l’AI Act oblige les entreprises à prendre des mesures pour promouvoir les compétences de leurs collaborateurs en matière d’IA. Depuis la modification apportée par le règlement (UE) 2026/1744 du 27 juillet 2026, elles ne sont toutefois plus tenues de garantir un niveau de compétence précis. Des formations pratiques sur les possibilités et les limites des traductions par IA constituent un élément pertinent.